Negli ultimi due anni l’intelligenza artificiale in azienda ha seguito quasi sempre lo stesso schema: il prompt parte dal client, l’elaborazione avviene nel cloud, il risultato torna indietro. Un modello semplice da adottare, ma che porta con sé tre domande ricorrenti per chi gestisce l’IT: quanto costa ogni richiesta, dove transitano i dati e cosa succede quando un agente AI inizia a eseguire azioni sul dispositivo dell’utente.
Con l’evento Windows e Surface del 7 ottobre a San Francisco, Microsoft prova a dare una risposta diversa. Il protagonista hardware è Surface Laptop Ultra, anticipato a inizio giugno e ora finalmente con prezzi e date di consegna, ma il vero messaggio è architetturale: la hybrid intelligence, cioè la capacità di eseguire un compito in locale quando ha senso e di passare al cloud quando serve. In questo articolo vediamo il dispositivo, il nuovo Copilot in Windows, la sicurezza degli agenti e il ruolo di GitHub HydraFusion.
Dall’AI nel cloud all’intelligenza ibrida
L’idea di fondo è che non tutte le richieste AI abbiano bisogno di un data center. Riassumere un documento riservato, analizzare un file locale, lavorare su un repository aziendale: sono attività che un dispositivo sufficientemente potente può gestire da solo, con latenze più basse, senza consumare crediti cloud e senza che i dati lascino il PC. Per i carichi più pesanti il cloud resta la scelta naturale.
Il punto non è sostituire il cloud, ma smettere di usarlo per tutto. Per un’azienda questo si traduce in un controllo più fine su costi, latenza e perimetro dei dati. A supporto c’è Windows ML, il runtime per eseguire modelli su CPU, GPU e NPU, che ora aggiunge anche il supporto a llama.cpp per semplificare l’uso dei modelli open source.
Surface Laptop Ultra: l’hardware per l’AI locale
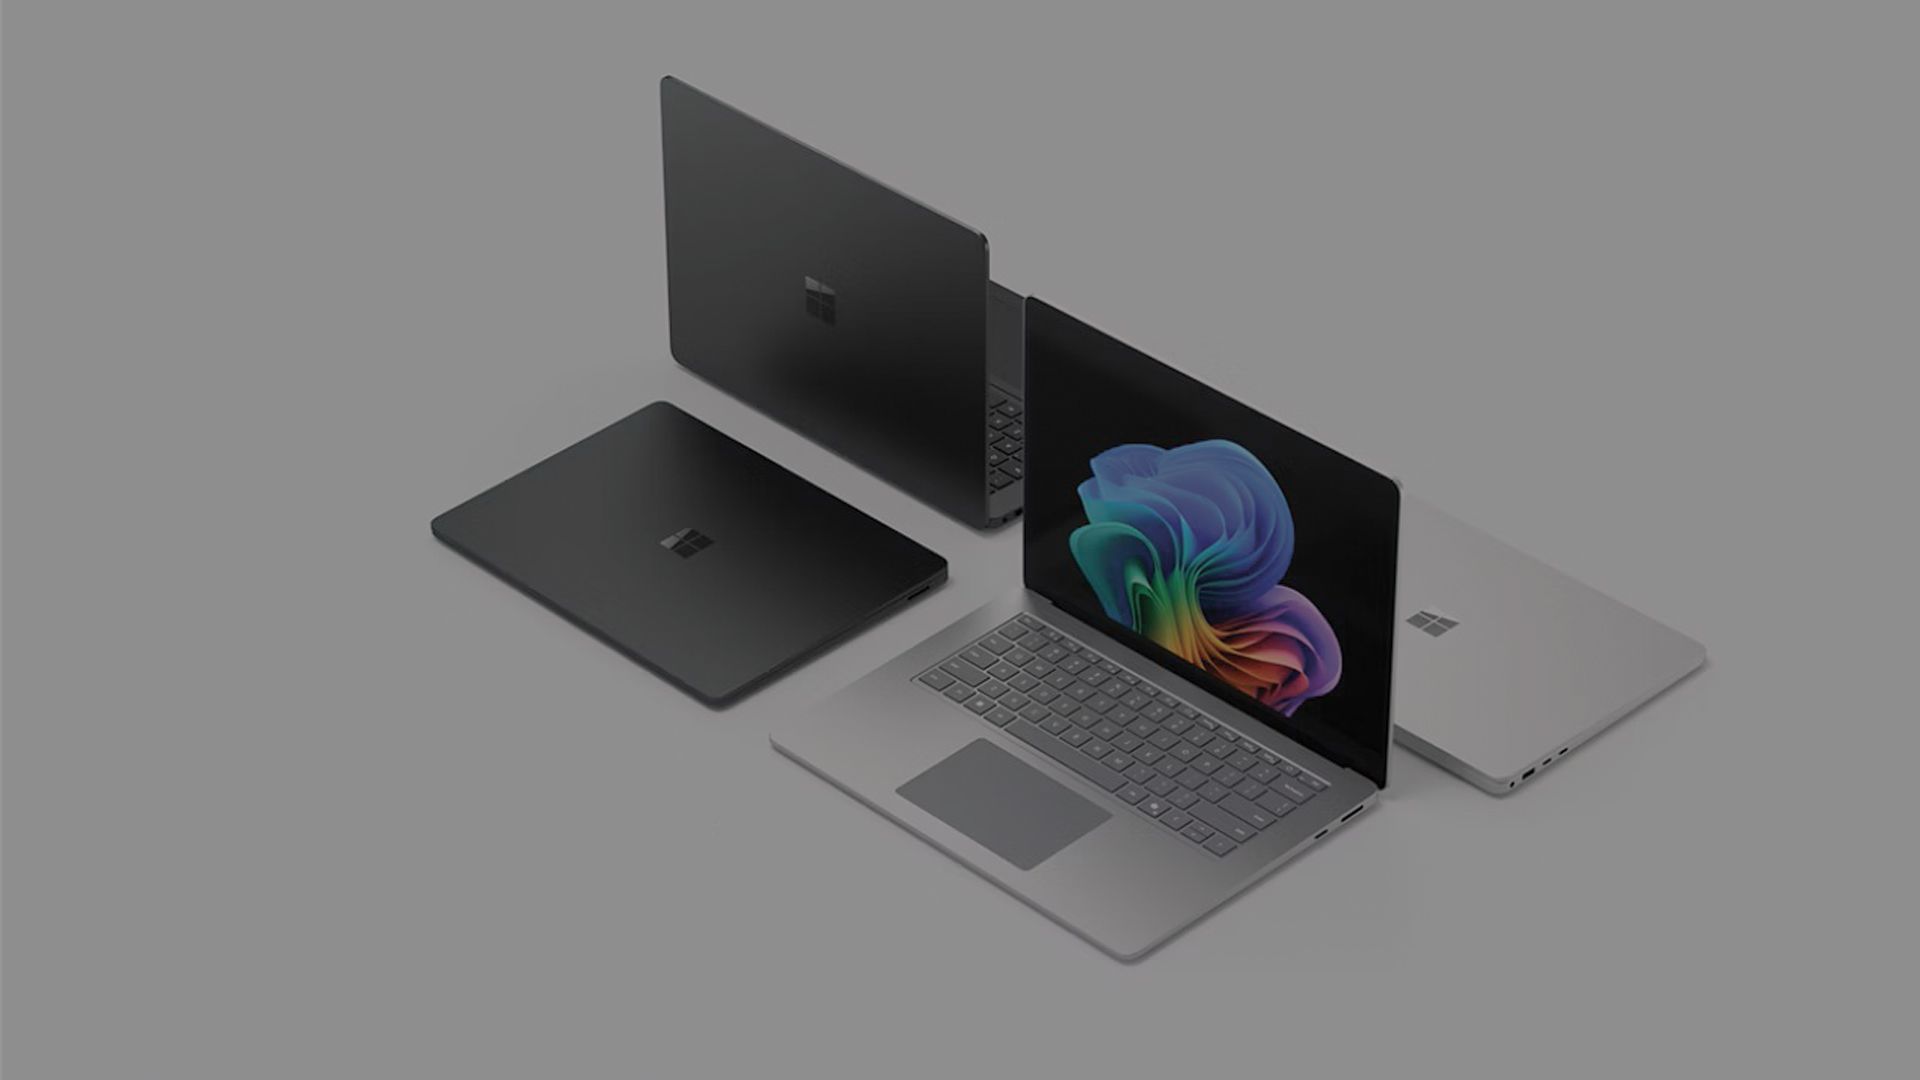
Perché l’intelligenza ibrida funzioni serve un dispositivo in grado di far girare modelli di grandi dimensioni. Surface Laptop Ultra è il Surface Laptop più potente mai realizzato da Microsoft ed è costruito attorno alla piattaforma NVIDIA RTX Spark.
- NVIDIA RTX Spark N1X — CPU NVIDIA Grace fino a 20 core e GPU Blackwell RTX fino a 6.144 core, per una capacità di calcolo AI fino a 1 petaflop. La configurazione d’ingresso ha CPU a 18 core e GPU a 5.120 core.
- Fino a 128 GB di memoria unificata — CPU e GPU condividono lo stesso pool di memoria. È il dato più importante per l’AI locale: con la configurazione massima si possono eseguire modelli oltre i 120 miliardi di parametri.
- Display da 15 pollici — touchscreen Mini-LED PixelSense Ultra con picco HDR fino a 2.000 nit.
- Dissipazione potenziata — un nuovo sistema termico con capacità fino a 2,5 volte superiore rispetto agli attuali Surface Laptop, in uno chassis sotto i 18 mm di spessore.
- Connettività — USB-C, USB-A, HDMI, lettore di schede SD e jack audio, con ricarica USB-C magnetica integrata (Magnetic Connect) e supporto fino a tre monitor 4K.
- Gestione e sicurezza — accesso con Windows Hello tramite riconoscimento facciale e SSD rimovibile dall’utente, utile per riparazioni e conservazione dei dati a fine ciclo di vita.
Negli Stati Uniti i preordini sono aperti, con consegne dal 16 ottobre. Le configurazioni partono da 2.599 dollari (18 core, 24 GB, 512 GB) e arrivano a 5.899 dollari per il modello con 128 GB di memoria. Sono previste anche configurazioni commerciali. Al momento non risultano prezzi in euro né una data di disponibilità per l’Italia: chi pianifica un refresh dei notebook di sviluppatori o creativi farà bene a tenerne conto.
Un punto da non sottovalutare: la memoria fa la differenza. Per eseguire in locale i modelli più grandi, come vedremo per MAI Code 1.1 Flash, serve in pratica la configurazione da 128 GB, cioè quella più costosa.
Il nuovo Copilot in Windows
L’hardware è solo metà della storia. L’altra metà è un Copilot più integrato nel sistema operativo.
- Tre spazi: Home, Code e Autopilot — Home lavora sui file e sulle attività recenti dell’utente, Code crea applicazioni Windows native a partire da richieste in linguaggio naturale, Autopilot evolve verso un agente personale che esegue compiti in autonomia.
- Impostazione Hybrid Intelligence — consente a Copilot, previa autorizzazione, di accedere ai file del PC, eseguire azioni in Windows e usare modelli locali senza costi aggiuntivi. L’arrivo sui Copilot+ PC è previsto nei prossimi mesi.
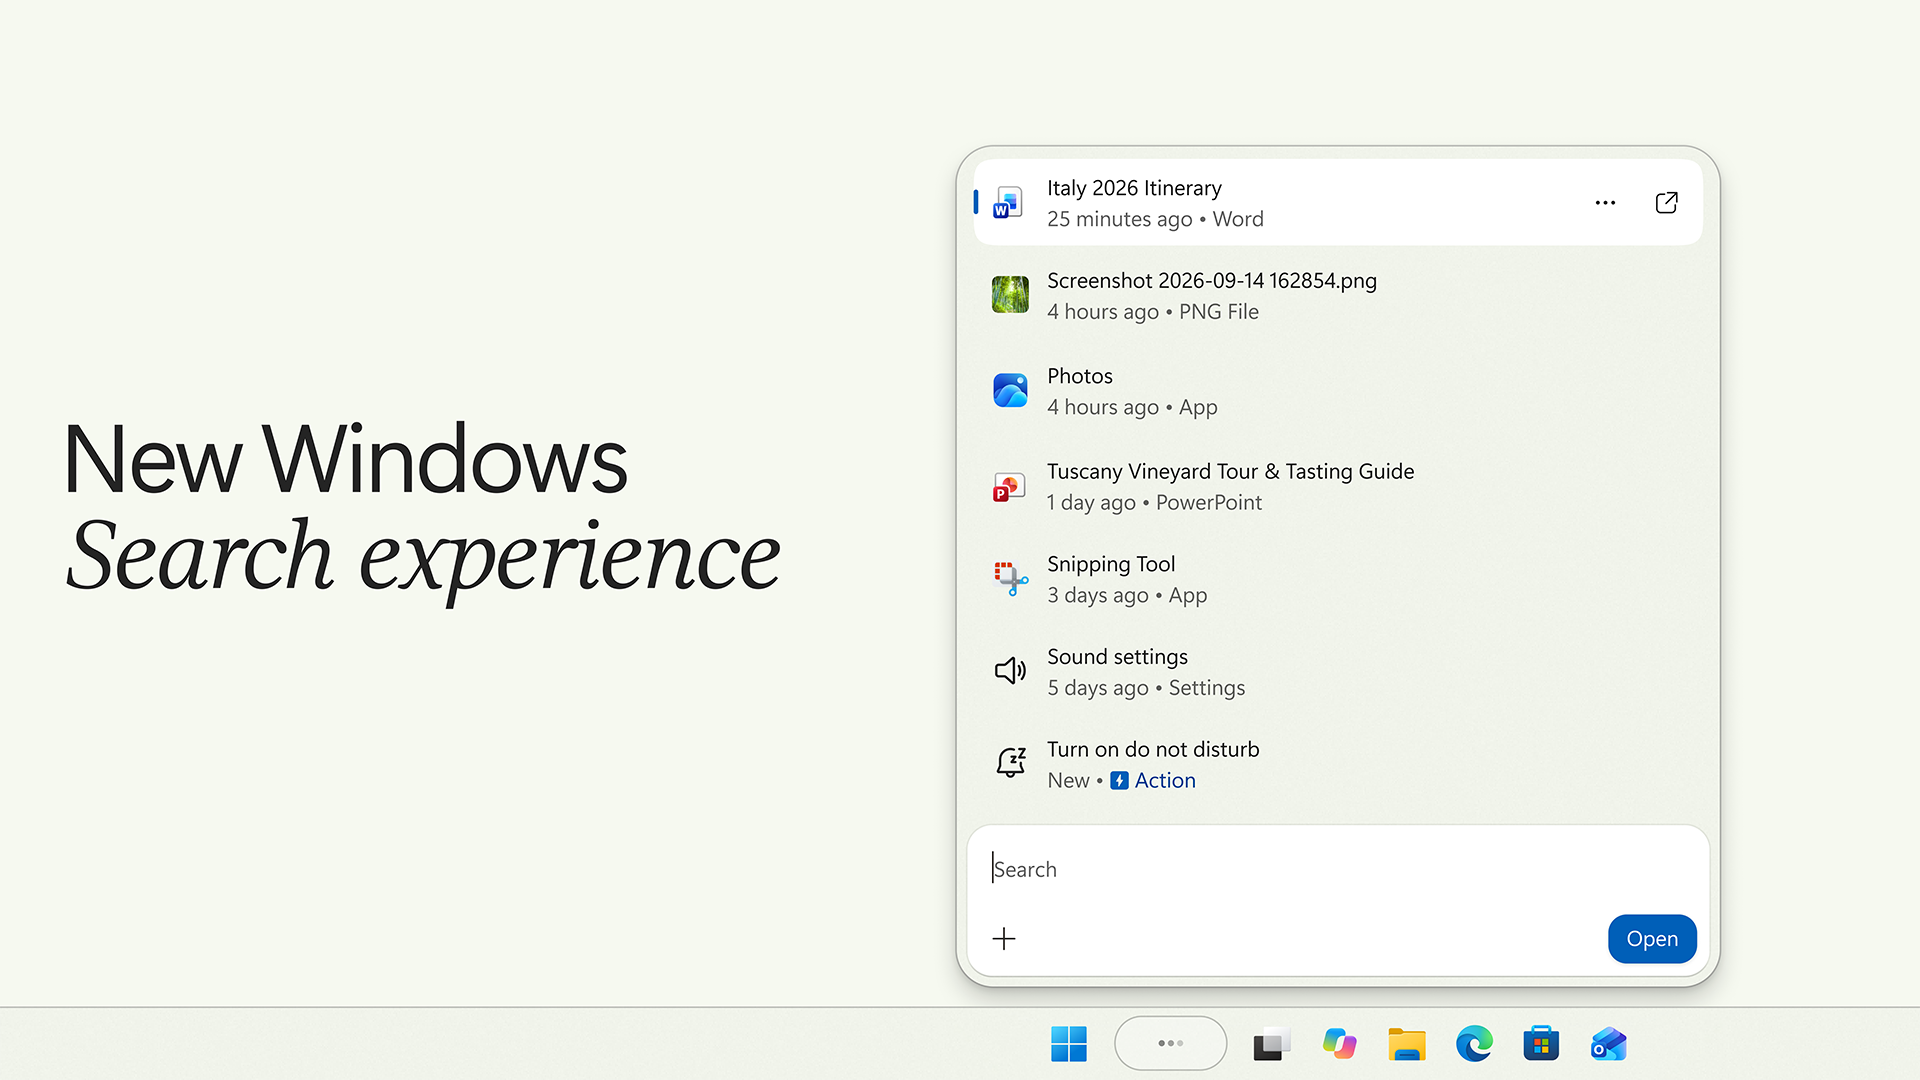
- Nuova ricerca di Windows — risultati unificati in un’unica lista (documenti, immagini, app e impostazioni), anteprime più ricche e azioni rapide eseguibili direttamente dalla casella di ricerca, come attivare la modalità Non disturbare. Un’impostazione opzionale collega Copilot alla ricerca per ottenere risposte immediate.
Agenti sì, ma con regole: Microsoft Execution Containers
Quando un agente può leggere file e lanciare comandi, la domanda per l’IT è inevitabile: con quali permessi? La risposta di Microsoft si chiama Microsoft Execution Containers (MXC), presentata a Build e ora disponibile in versione generale su Windows 11.
MXC è un livello di esecuzione open source, basato su policy, che confina i processi avviati da un agente in un perimetro controllato dal sistema operativo: si definisce in modo dichiarativo a quali file, risorse di rete e capacità di sistema l’agente può accedere, indipendentemente dal modello AI che ha richiesto l’operazione. GitHub Copilot, OpenAI Codex e NVIDIA hanno già integrato il supporto, con Meta in arrivo.
Per le aziende il valore sta nell’integrazione con Agent 365, che aggiunge sopra MXC i controlli di Entra, Intune, Defender e Purview. In pratica gli agenti diventano oggetti governabili con gli stessi strumenti già usati per identità e dispositivi: un tassello essenziale per portarli in produzione in un contesto zero trust.
GitHub HydraFusion: orchestrare i modelli invece di sceglierli
Il terzo elemento riguarda chi sviluppa software. Project HydraFusion è una research preview di GitHub Copilot presentata il 4 settembre, oggi accessibile tramite la modalità sperimentale di Copilot CLI su tutti i piani.
Finora lo sviluppatore sceglieva un modello, oppure lasciava alla modalità Auto la scelta del modello migliore per ogni richiesta. HydraFusion fa un passo in più: costruisce l’intero flusso di lavoro e, per ogni attività, applica uno di tre schemi.
- Single — un solo modello risolve il compito direttamente.
- Cascade — un modello più efficiente produce una prima soluzione; se non supera un controllo di qualità, il lavoro passa a un modello più capace.
- Critique — un modello produce la soluzione, un modello di un’altra famiglia la revisiona, e il primo la corregge una volta sulla base dei commenti.
Nelle valutazioni pubblicate da GitHub su TerminalBench 2.1, HydraFusion ha ottenuto 4,9 punti percentuali in più rispetto a Claude Opus 5, con un costo stimato inferiore del 67%. Sono test controllati e dipendenti dalla configurazione: indicano la direzione, non sono una garanzia per ogni codebase.
Dal cloud al notebook: HydraFusion diventa ibrido
La novità di ottobre è l’estensione di questa logica al dispositivo. Entro fine mese GitHub Copilot potrà decidere se un’attività va gestita da un modello locale o da un modello cloud, in base al carico e alle risorse disponibili. Il supporto arriverà in anteprima sperimentale nell’app GitHub Copilot, in Copilot CLI e in Visual Studio Code.
Il modello locale di riferimento è MAI Code 1.1 Flash, lo stesso che Microsoft già usa in produzione in GitHub Copilot: un modello mixture-of-experts da 137 miliardi di parametri. Grazie alla quantizzazione a 3 bit occupa circa 53 GB, quasi l’80% in meno della versione cloud, e mantiene l’intera finestra di contesto da 256K token. I risultati restano vicini: su SWE-Bench Verified la versione locale si attesta al 70,8% contro il 72,6% di quella cloud. Microsoft raccomanda però oltre 120 GB di RAM, il che oggi significa la configurazione da 128 GB.
Gli sviluppatori potranno lasciare che la modalità Auto decida dove eseguire ogni passaggio, oppure selezionare esplicitamente un modello locale tramite il provider Windows ML o qualsiasi endpoint locale compatibile con le API OpenAI. Anche l’esecuzione dei comandi può avvenire nelle sandbox MXC.
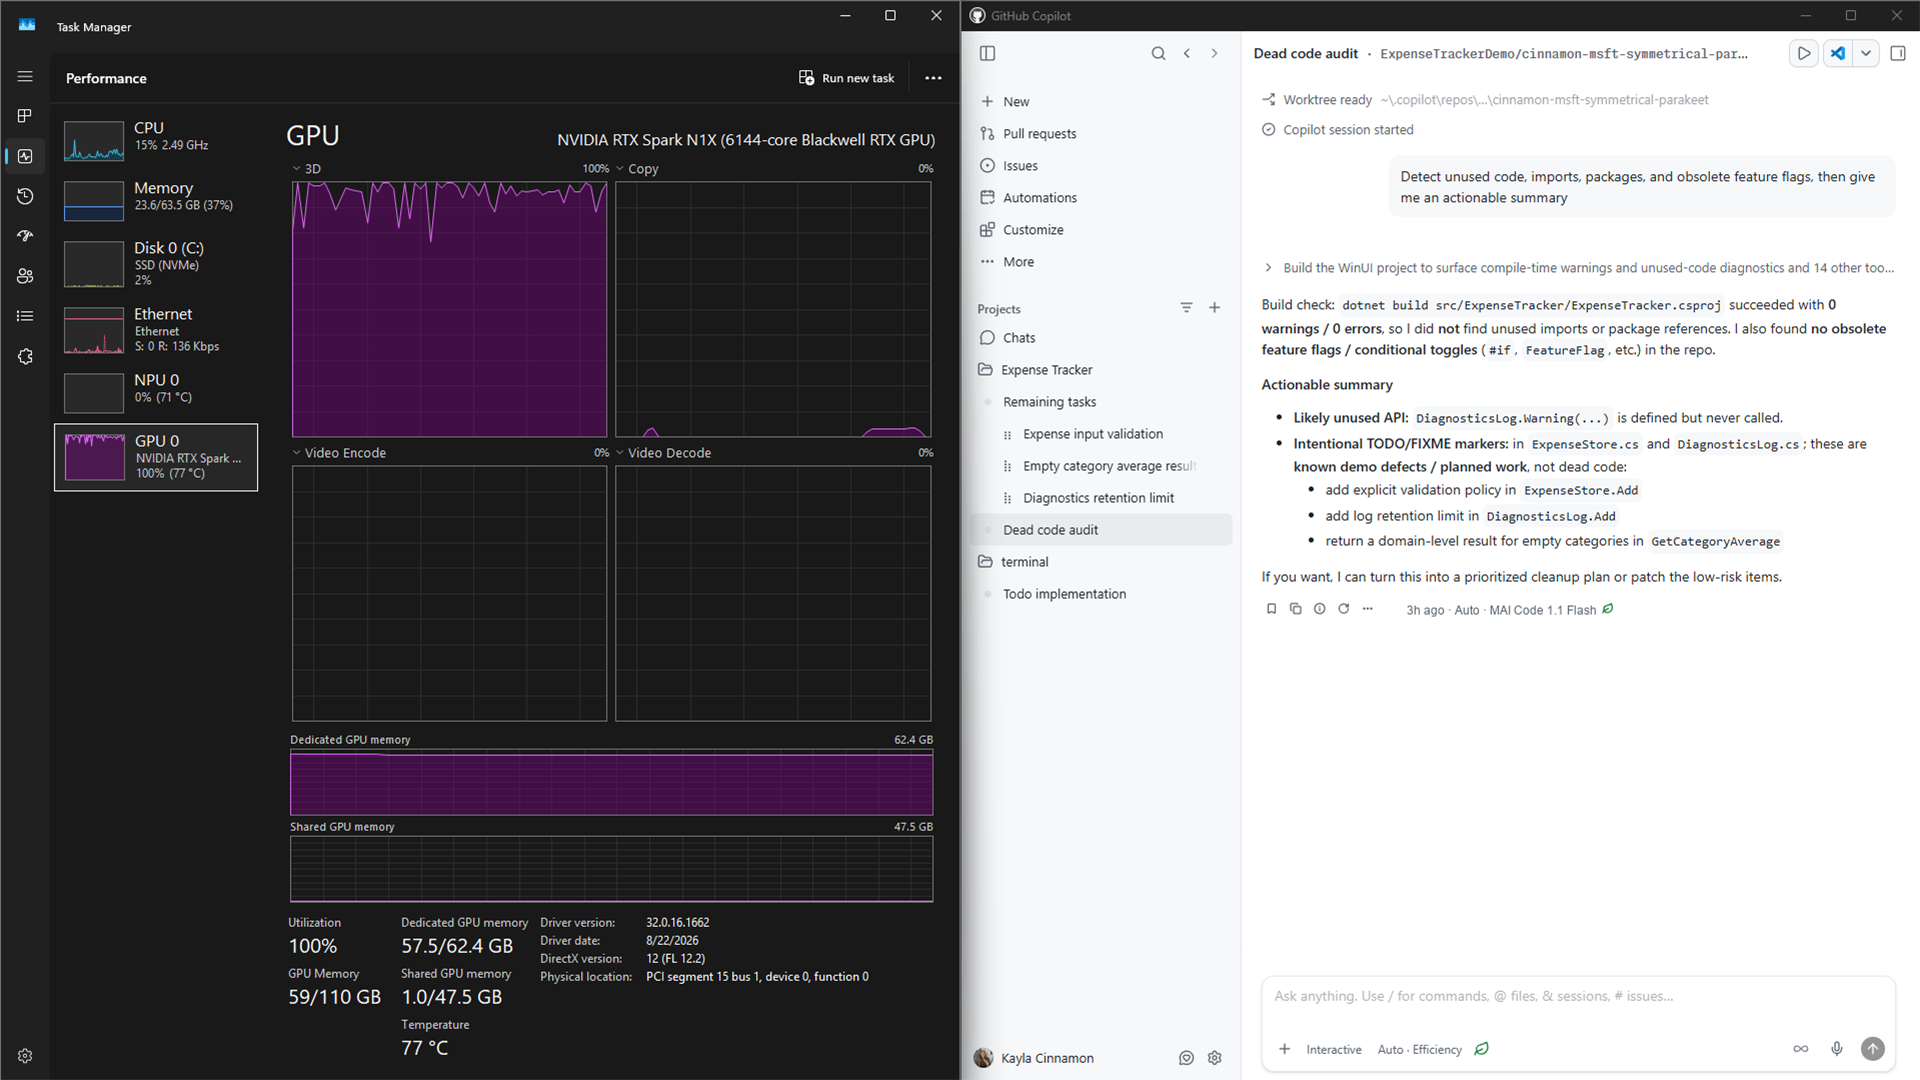
L’immagine rende bene l’idea: la richiesta parte dall’app GitHub Copilot in modalità Auto, il modello scelto è MAI Code 1.1 Flash e l’elaborazione avviene interamente sulla GPU del notebook, senza consumare crediti cloud.
Cosa significa per le aziende
Al di là dell’hardware, l’annuncio indica una direzione chiara: l’AI aziendale diventa ibrida per progetto, non per eccezione. Dal nostro punto di vista di system integrator, gli impatti più concreti sono quattro.
- Controllo dei costi — spostare in locale le attività ripetitive, come automazioni di sviluppo o analisi di file, riduce il consumo di crediti e token cloud.
- Perimetro dei dati — codice sorgente, documenti riservati e dati dei clienti possono essere elaborati senza lasciare il dispositivo, un tema centrale per compliance e sovranità del dato.
- Governance degli agenti — con MXC e Agent 365 le aziende possono definire cosa un agente può fare, con gli stessi strumenti usati per identità, dispositivi e protezione degli endpoint.
- Produttività dei team di sviluppo — HydraFusion e i modelli locali riducono il tempo speso a scegliere modelli e configurazioni, lasciando al sistema l’equilibrio tra qualità, costo e latenza.
Restano alcune cautele: HydraFusion è ancora in research preview e il supporto ai modelli locali arriverà in anteprima sperimentale; le funzioni locali più ambiziose richiedono la configurazione di fascia più alta; la disponibilità italiana di Surface Laptop Ultra non è ancora ufficiale. È il momento giusto per valutare, non per adottare a scatola chiusa.
Conclusioni
Surface Laptop Ultra non è semplicemente un notebook più potente: è la piattaforma con cui Microsoft dimostra che l’AI può essere distribuita tra dispositivo e cloud in base al compito, al costo e alla sensibilità dei dati. Il nuovo Copilot in Windows, Microsoft Execution Containers e GitHub HydraFusion sono i pezzi software che rendono questa visione utilizzabile e governabile.
Per le aziende che stanno definendo la propria strategia AI, la domanda non è più solo “quale modello usare”, ma “dove farlo girare e con quali regole”. Impostare oggi policy, sicurezza e criteri di scelta dei dispositivi significa arrivare pronti quando questa architettura diventerà lo standard.